
MooFetch
Aplicación de terminal multiplataforma, escrita en Go, que descarga el material de tus cursos Moodle. Pensada para la Universidad de la Frontera, usable en cualquier campus virtual, y construida como banco de pruebas de un flujo de trabajo guiado por especificaciones con Claude Code.
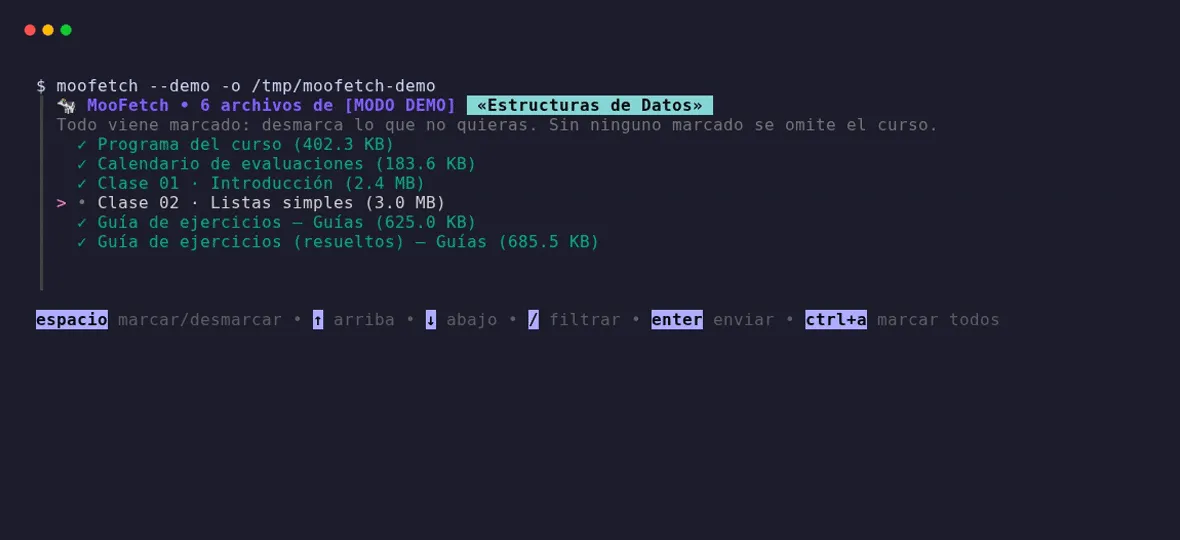
De qué se trata
MooFetch es una aplicación de terminal que descarga los archivos de tus cursos desde un campus Moodle. Nació para el campus virtual de la Universidad de la Frontera (UFRO), pero no depende de ella: con --domain funciona con cualquier Moodle.
El problema es simple y molesto. Al terminar el semestre tienes decenas de PDFs repartidos por el campus, y wget o curl no sirven: el campus exige sesión y redirige al login, así que terminas con “PDFs” de 2 KB que en realidad son HTML. MooFetch inicia sesión, lista tus cursos, secciones y archivos por nombre (no por enlace), te deja elegir y descarga todo en paralelo, ordenado como curso/sección/archivo.
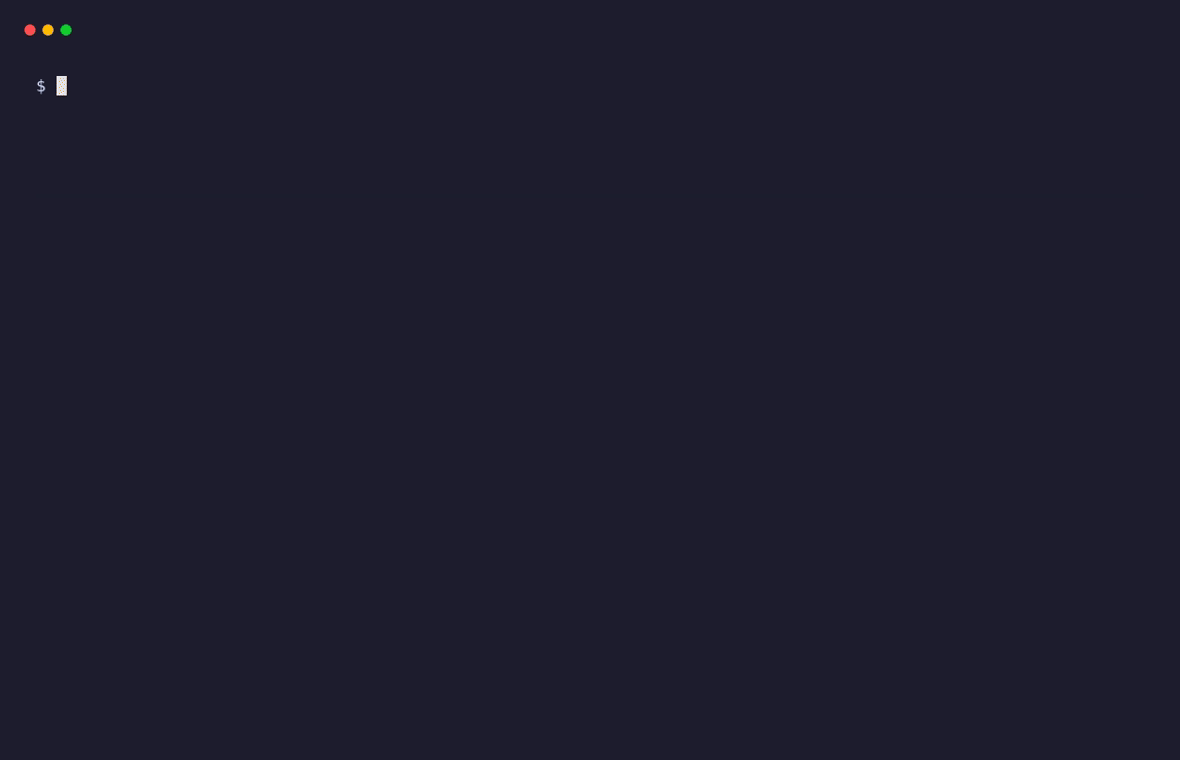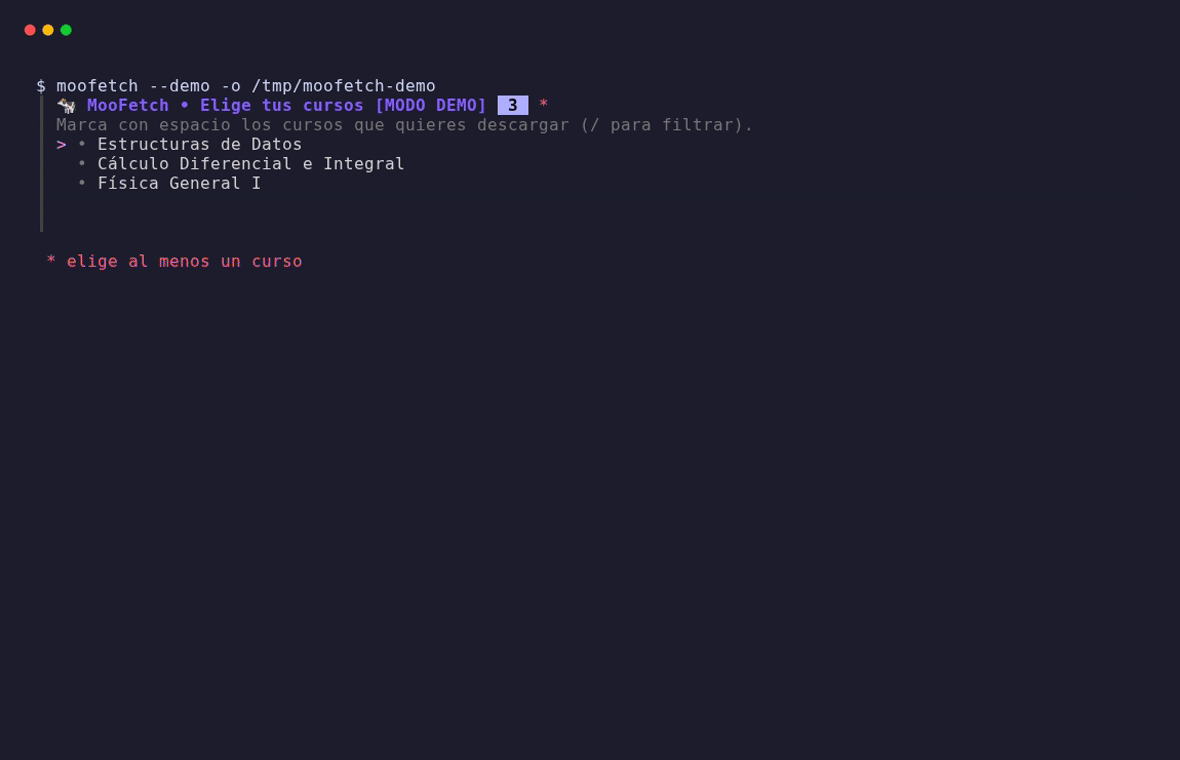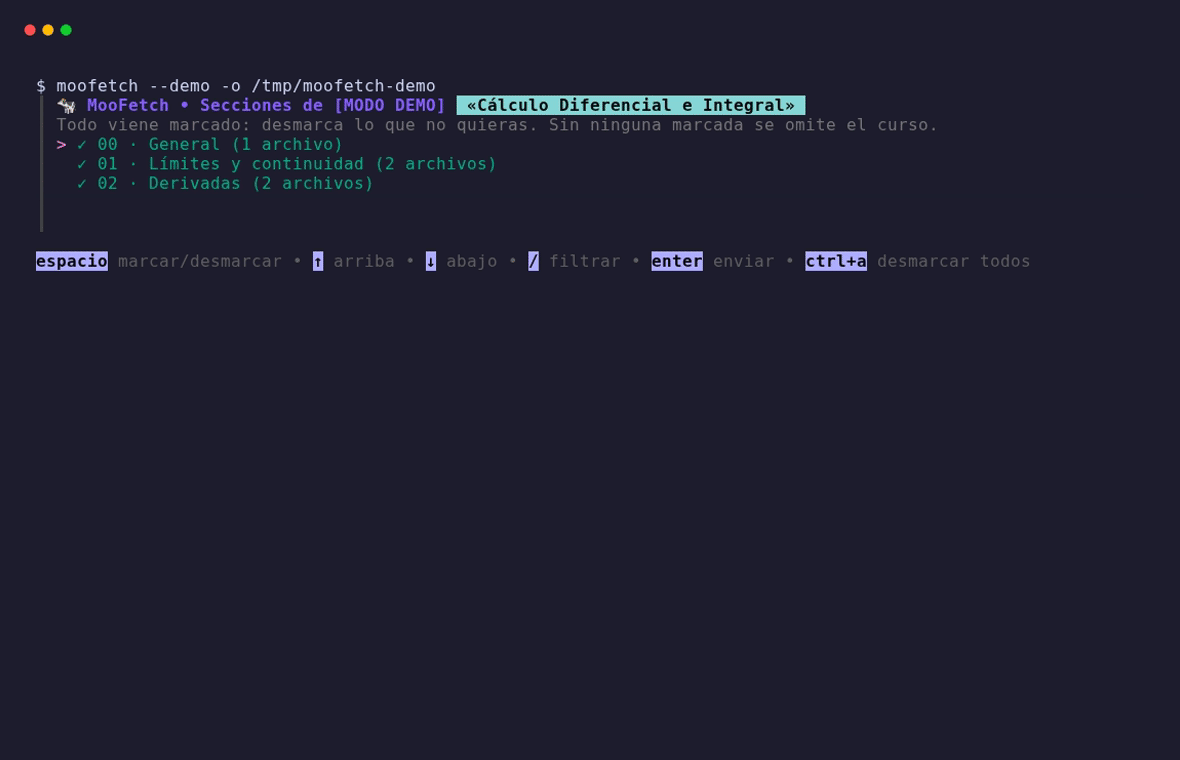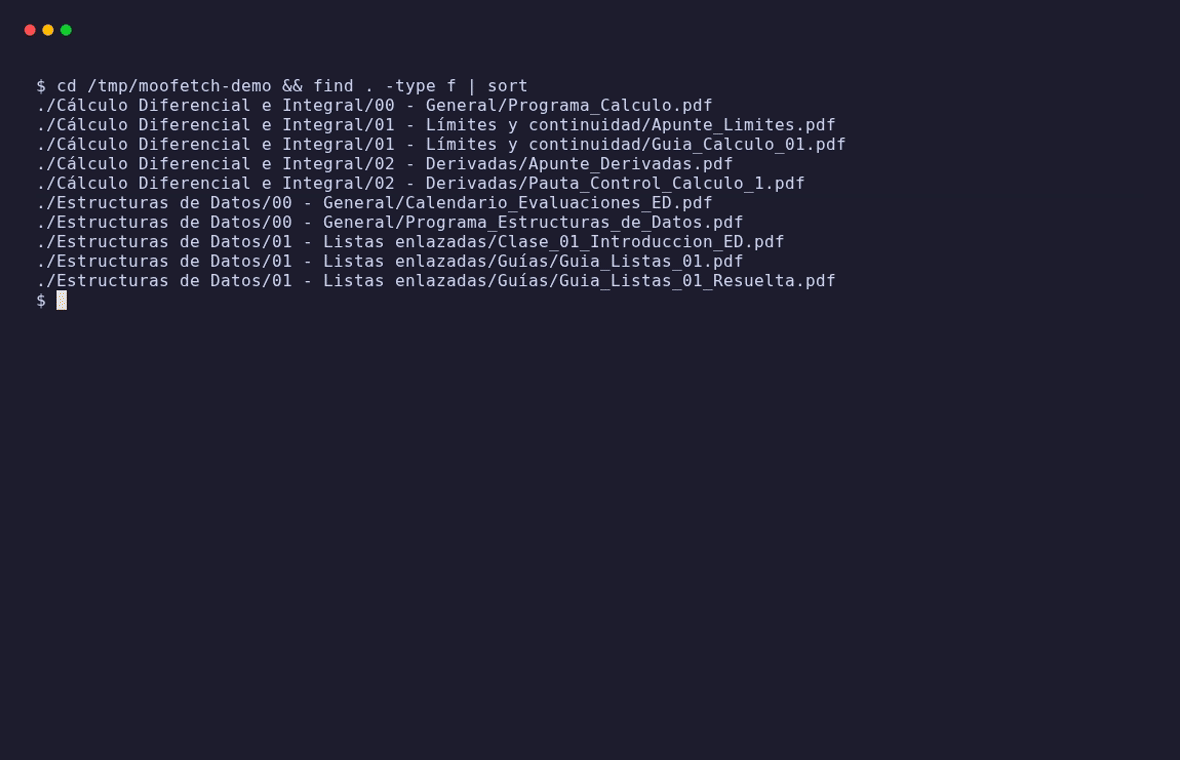
La demo corresponde a moofetch --demo, que recorre las mismas pantallas que la app real pero sin red ni credenciales.
El código es público: github.com/sebasinmas/MooFetch.
De un script de Bash a una herramienta de verdad
Empezó como un script de Bash: un curl con una cookie pegada a mano. Funcionaba, pero cada mejora lo hacía más frágil.
- Bash. Resolvía mi caso, pero sin concurrencia controlada, sin manejo decente de errores y sin forma de probarlo.
- Go sin librerías. Reescribí el script usando solo la biblioteca estándar y el paquete
flag. Ahí aparecieron las ventajas de un binario único, la concurrencia con goroutines y los tests. - Cobra. Para que fuera una herramienta robusta tuve que dejar atrás el
flagbásico: subcomandos (run,scan,doctor,version), ayuda agrupada, y un contrato claro con el resto del sistema operativo. De ahí salen los pipelines y los códigos de salida. - Bubble Tea y Charm. Con el motor estable, sumé la interfaz interactiva: un asistente de una decisión por pantalla, con barras de avance por archivo.
El stack final es Go, Cobra para la CLI, y Bubble Tea, Huh y Lip Gloss (el ecosistema de Charm) para la interfaz de terminal.
Una herramienta que se integra, no solo se usa
MooFetch detecta si su entrada o salida es una tubería y cambia solo a modo headless: el progreso va a stderr y stdout queda limpio para encadenar comandos.
# Listar los recursos de un curso y descargarlos
moofetch scan "https://campusvirtual.ufro.cl/course/view.php?id=123" --uni ufro > urls.txt
moofetch run -f urls.txt --uni ufro -o ./apuntes

# Filtrar con grep y descargar en paralelo
grep "pdf" urls.txt | moofetch run --uni ufro --headless -c 6
Los códigos de salida siguen sysexits.h, para que un script o un pipeline reaccione con precisión: 0 éxito, 1 error general, 2 uso incorrecto, 77 sesión inválida o expirada y 130 interrumpido por el usuario. Distinguir “se venció tu sesión” de “falló la red” es lo que separa una herramienta de terminal de un programa que casualmente corre en una terminal.
Arquitectura
El núcleo es un microkernel estático con una mirada hexagonal: el kernel orquesta las descargas, los plugins (Moodle, y uno de demo) las ejecutan, y la interfaz solo consume eventos. La TUI y el modo headless son dos adaptadores del mismo motor, y por eso mañana podría haber una GUI o una extensión de navegador sin tocar el kernel.
Algunas decisiones que me importan:
- Worker pool acotado con un semáforo de canales: da igual descargar 5 o 5.000 archivos, nunca hay goroutines descontroladas.
- Escrituras atómicas: cada archivo se baja a un
.party se renombra al terminar. Si se cancela o falla, no quedan restos. - Circuit breaker de sesión: ante un 401, un 403 o una redirección al login, el lote completo se aborta (fail-fast) en vez de lanzar cientos de peticiones inútiles.
- Amable con el campus: descargas acotadas y un escáner que pide las páginas de a una, con pausa y respetando
Retry-After.
Privacidad por diseño
La contraseña se lee con el eco desactivado, se usa una vez para pedir un token a la API móvil de Moodle y se descarta. El token vive solo en memoria, nunca forma parte de una URL (se agrega a la petición en el último momento, así que no puede aparecer en pantalla ni en logs) y los logs lo enmascaran. Además, el token solo se envía al host de tu campus.
Multiplataforma
MooFetch compila para Linux, Windows y macOS (en Mac, un único binario universal que sirve tanto para Intel como para chips Apple), sin CGO, así que el binario no arrastra dependencias del sistema.
Funcionar en tres sistemas no es lo mismo que compilar en tres sistemas, y Windows me lo enseñó:
- Mi primera estrategia de acceso era leer la cookie de sesión desde el navegador. En Windows eso se topó con dos paredes: los navegadores mantienen sus archivos bloqueados mientras están abiertos, y Chrome y Edge cifran las cookies de una forma que la librería que usaba no puede deshacer. Esa limitación fue la que motivó cambiar el acceso por defecto a usuario y contraseña mediante la API móvil de Moodle, dejando la cookie como alternativa.
- Las consolas clásicas (cmd y el PowerShell antiguo) no borran bien lo que se redibuja, así que la TUI elige por defecto una pantalla completa temporal y símbolos ASCII, con variables de entorno para ajustarlo.
- Las rutas largas con carpetas anidadas se acortan solas para no pasar el límite de 260 caracteres.
- Hay un comando
moofetch doctorque diagnostica qué navegadores y perfiles encuentra, sin imprimir nunca valores de cookies, y cuya tabla se puede pegar en un issue.
Todo lo que rodea al código
Una de las razones para hacer MooFetch fue practicar el ciclo completo de un proyecto, no solo la parte de programar.
CI en cada pull request
GitHub Actions valida cada PR hacia main y develop:
| Job | Qué verifica |
|---|---|
gofmt |
Formato estándar de Go |
golangci-lint |
Análisis estático |
traceability |
Que la tabla de trazabilidad esté al día con su fuente |
goreleaser check |
Que la configuración de release sea válida |
test |
Tests con el race detector y reporte de cobertura |
build-dry-run |
Compilación cruzada a Linux, Windows y macOS (Intel y Apple), más go vet para Windows |
Un workflow aparte exige que el título de cada PR sea un Conventional Commit, porque con squash-merge ese título es la línea que termina en las notas de la release.
Release automática
Al empujar un tag vX.Y.Z desde main, otro workflow ejecuta GoReleaser: compila con las versiones, el commit y la fecha inyectados, empaqueta con nombres fijos (MooFetch-Windows.zip, MooFetch-Linux.tar.gz, MooFetch-Mac.zip), genera checksums.txt con SHA-256 y publica la release con un changelog agrupado por tipo de cambio (feat, fix, security, refactor…). Los tags -rc o -beta salen como prerelease.
Por decisión de proyecto no uso runners de Windows ni macOS en Actions, así que para eso lo compensa un script que genera los binarios y los tests de Windows desde Linux, y una regla que me impuse: no se crea un tag sin probar antes en un Windows real.
El binario no está firmado
Quiero ser transparente con esto. La cadena de CI/CD que armé llega hasta el release, pero no incluye firma de código: los certificados para Windows y la cuenta de desarrollador de Apple tienen un costo anual que, por ahora, no pude cubrir para un proyecto personal. La consecuencia es la esperable: Windows muestra el aviso de SmartScreen y macOS puede poner el archivo en cuarentena, y el README explica cómo continuar en cada caso.
Lo que sí puedo ofrecer a cambio:
- El código fuente es público y auditable.
- Los binarios de cada release se construyen en GitHub Actions a partir del tag, no en mi computador.
- Cada release publica
checksums.txtpara verificar la descarga. - También se puede compilar desde el código con
go install.
No reemplaza una firma, pero permite que cualquiera compruebe qué está ejecutando.
Un experimento con un harness: Claude Code
MooFetch fue, además, mi banco de pruebas para entender cómo se trabaja bien con un harness de agentes (Claude Code). El proyecto fue escalando junto con mi forma de usarlo:
- Solo instrucciones. Pedirle cosas a una sesión en blanco. Rápido para empezar, pero cada sesión partía sin memoria de las decisiones anteriores.
- Contexto persistente. Archivos de contexto en el repo con las convenciones, la arquitectura y las reglas del proyecto, para que cada sesión arrancara informada.
- Agentes personalizados. Roles con un trabajo acotado, en lugar de una sola conversación que hace de todo.
- Scripts, hooks y trazabilidad. Automatizar lo que no debería depender de que alguien se acuerde: validaciones, verificaciones y archivos que dejan registro de qué se hizo, cuándo y por qué.
La configuración local del harness no se versiona en el repositorio. Lo que sí queda versionado es lo que importa, porque sirve igual para una persona que para un agente: las especificaciones, las decisiones y el estado del trabajo.
SDD: la especificación como fuente de verdad
Todo lo anterior descansa en SDD (specification driven design): antes de escribir código, escribir qué se quiere y por qué. En MooFetch eso toma forma concreta:
- ADRs (Architecture Decision Records): hay seis, y cada uno registra el contexto, la decisión y los riesgos de un cambio importante. Por ejemplo, el ADR 001 documenta el paso a Cobra, los pipelines y los códigos de salida, y el ADR 006 la autenticación por la API móvil.
- Tareas con definición de terminado (
docs/tasks/): cada una con sus pasos, su dependencia con otras tareas y un DoD explícito. Las que tocan los mismos archivos se ejecutan en worktrees aislados para que los agentes no se pisen. - Trazabilidad: un
traceability.jsoncon más de 40 funcionalidades (fecha, rama, commit, versión y estado). La tabla en Markdown se genera desde ese archivo y el CI falla si está desactualizada. De ahí también salen los patchnotes. - Spikes como compuerta humana. Antes de construir el login por API móvil, hice una prueba de concepto manual contra el campus real. Solo después de confirmar que funcionaba, el ADR pasó a “aceptado” y se escribió la implementación.
Una de las cosas que más valoro de este enfoque es que obliga a la honestidad. La TASK-04 (autodetección de la cookie) está marcada como hecha, pero su propia ficha aclara que solo se verificó con tests y un proveedor de cookies falso, y que la comprobación manual en los navegadores reales seguía pendiente. La especificación no solo dice qué se quería, también deja en evidencia qué falta comprobar.
ODD: mirar el resultado, no la actividad
Lo que me interesa explorar a continuación es ODD (output/objective driven design): definir primero el resultado observable que debe cumplirse y dejar que la forma de llegar a él sea flexible. MooFetch ya tiene piezas de esa idea, como los códigos de salida que funcionan como contrato verificable, el rechazo de un .pdf cuyo contenido no empieza con %PDF-, o los DoD de las tareas. Lo que viene es hacerlo más explícito: que cada objetivo se exprese como un resultado medible que un agente pueda verificar por sí mismo, en vez de describir los pasos para obtenerlo.
La hipótesis con la que sigo trabajando es que SDD y ODD se complementan: la especificación fija el qué y el por qué, y el objetivo medible permite comprobar cuándo se cumplió.
Qué sigue
El roadmap incluye verificar manualmente la detección de cookies en cada navegador y plataforma, soportar carpetas anidadas con recursión, una extensión de navegador, una aplicación de escritorio que reutilice el mismo núcleo, soporte para otros LMS (Canvas, Blackboard) y publicación en gestores de paquetes como brew, scoop y winget.
Puedes descargar la última versión desde Releases o probar el flujo completo, sin cuenta ni red, con moofetch --demo.
Uso responsable: MooFetch sirve para respaldar material de estudio al que ya tienes acceso legítimo. Respeta las políticas de uso de tu institución.